Novel Staging
给 AI 短剧的每一场排开场站位:先从场景图里认出能站能坐的东西(推算到俯视平面上), 再按剧本给每一场排谁在哪件东西的哪一侧、坐还是站、面朝哪、有没有群演,...
Install
npx skills add eternityspring/shuohao-skills --skill novel-staging -g -a claude-code -y- Repository
- eternityspring/shuohao-skills5.8k
- Category
- Engineering
- Updated
- 10d ago
- License
- Apache-2.0
- Context cost
- Lightabout 1,134 tokens
- Runs scripts
- Yes, review before use
What it does
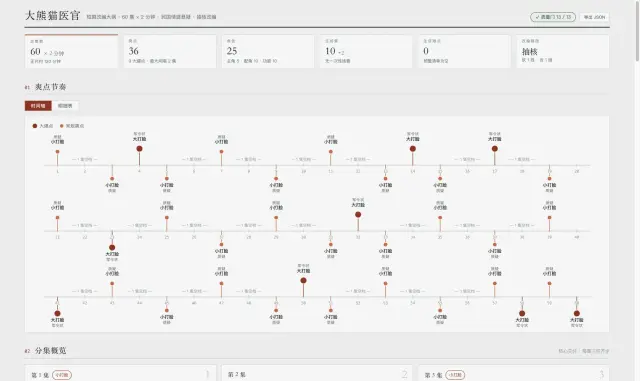
给 AI 短剧的每一场排开场站位:先从场景图里认出能站能坐的东西(推算到俯视平面上), 再按剧本给每一场排谁在哪件东西的哪一侧、坐还是站、面朝哪、有没有群演, 程序写出每一场的开场走位句,分镜这一场第一段照抄它。 默认交付能拖动调整站位的 HTML 工具报告,页面内可导出 staging.json;JSON 同时作为工作数据保存,Markdown 按需导出。 8 道质量门全部由脚本确定性检查(认图件数、东西在图上、出场人物不多不少、在场的人落在认出来的东西上、 同一侧不叠人、群演写明在哪……)。吃 novel-script 的 script.json 和 novel-art 的 art.json 预填骨架。 零依赖、零 API key。 Use when asked to 站位、开场站位、群戏站位、谁坐在哪、排座位、走位、blocking、staging for AI short drama。
novel-staging
给 AI 短剧的每一场排开场站位:这一场一开始,每个出场的人在哪件东西旁、坐还是站、面朝哪。
为什么要单独排:短剧的每一段视频是一次独立生成,各段自己决定谁坐哪。群戏里六个人围一张长桌,第一段桌边多出五个没名字的宾客,第三段端酒坐着的人穿着主角的衣服。分镜的走位句一段接一段地交接,可每一场第一段的那一句是分镜自己编的,人看不到、改不动。所以在分镜之前,每场先定一份站位,分镜照抄。
| 交付 | 解决什么 |
|---|---|
| 认图结果(每个地点 4, 20 件东西) | 站位只落在图上真有的东西旁, , 提示词里写了、图上没画的高台,人坐上去,每段视频都不一样 |
| 俯视平面 | 在透视的场景图上「桌子北侧」只是桌子后面一小条,前后深浅说不清;摆平了从上往下看,方位一目了然 |
| 开场站位(每场) | 谁开场就在、谁后来才进;坐还是站跟着剧本;主位、对立、孤立用位置说出来 |
| 开场走位句 | 程序按站位写,一字不差交给分镜:「胡二爷坐在第三排坐板上,面朝北;其余座位空着,没有其他人。」 |
| 能调整的报告 | 人在页面上拖动、改坐站和朝向,改完导出就是新的 staging.json,不用手改 JSON |
{baseDir} = 本文件所在目录。脚本 {baseDir}/scripts/novel-staging.mjs,零依赖,node 直接跑。
边界(不做的事):不写分镜、不写剧本、不出图。只管开场那一刻, , 中途谁站起来、走到哪,是分镜的事,分镜从这一刻往后接着写。
Step 0, 定输入
- script.json(novel-script 的产出), , 硬前提:有哪几场、每场在哪个地点、谁出场、剧本怎么写的
- art.json(novel-art 的产出), , 地点的名字;还没有图时,按它的锚点和主视角提示词推算
- outline.json(novel-outline 的产出), , 人物编号对应的名字(C01 → 沈知微)
- 场景图, , 每个地点一张,放在
images/<地点名>-sheet.png(novel-art 的设定图版面,主视角在左上)。最好有:站位要落在图上真有的东西旁。没有图也能先排,但只是草稿(见 Step 2)
Step 1, seed 骨架
node {baseDir}/scripts/novel-staging.mjs seed <script.json> --art <art.json> --outline <outline.json> > <workdir>/staging.json
确定性搬运:地点(按第一次出现的顺序)、每一场的集号场号、在哪个地点、光照时段、出场人物,每个人一条空的站位。这些事实不要让模型重新想一遍。 只要其中几集就加 --eps 1-3。
Step 2, 认图(每个地点一次)
每个地点一份任务,能并发就并发。读 {baseDir}/references/read-pass.md,照着做:看场景图的主视角,认出人会站在旁边、坐在上面的东西,每件写名字、另一种语言、图上的框(box)、平面上的位置(plan)、能不能坐(on)、是不是圆的(round),4, 20 件,readFrom 写 picture。
最重的两条:图里看不到的不写(提示词里有、图上没有的一律不写);plan 按透视推算,不是照抄 box。
还没有图:按 art.json 的锚点和主视角提示词推算,readFrom 写 prompt、不写 box。报告会标出来;图出来以后重新认一遍、核对站位。
Step 3, 排站位(每场一次)
每场一份任务,能并发就并发(同一个地点连着几场的,按顺序排,保持位置连贯)。读 {baseDir}/references/staging-pass.md,拿这一场的剧本、出场人物和这个地点认出来的东西,给 places 里每个人填:开场在不在(present)、在哪件东西(item)的哪一侧(side)、沿这一侧多远(along)、坐还是站(posture)、面朝哪(facing);再填群演(extras / extrasWhere)和一句 why。
最重的三条:后来才进来的人开场不在;剧本没写有别人就没有群演;只使用认出来的那些东西。



