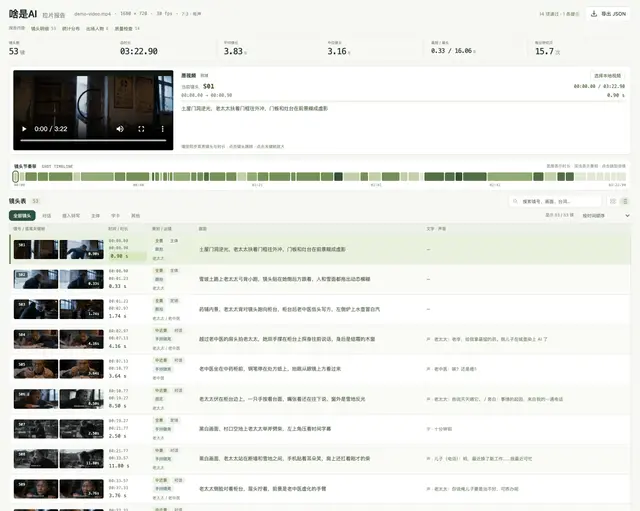
Video Shots
拉片:把一条成片拆成逐镜头的分析表, , 每个镜头的时长、景别、类别、运镜、画面。 分工刻在骨子里:**能量的都由代码量**(切点来自 ffmpeg 场景检测,时长是切点相减,...
Install
npx skills add eternityspring/reelbench-skills --skill video-shots -g -a claude-code -y- Repository
- eternityspring/reelbench-skills1.2k
- Category
- Media
- Updated
- 12d ago
- License
- Apache-2.0
- Context cost
- Mediumabout 1,504 tokens
- Runs scripts
- Yes, review before use
What it does
拉片:把一条成片拆成逐镜头的分析表, , 每个镜头的时长、景别、类别、运镜、画面。 分工刻在骨子里:**能量的都由代码量**(切点来自 ffmpeg 场景检测,时长是切点相减, 运动量是逐帧差分的中位数),模型只判断它真正该判断的那几件事(景别 / 类别 / 运镜 / 画面 / 节奏), 然后每一条判断都被代码当场对账, , **声称推拉摇移却实测几乎不动,门直接拦**。 看片走联系表(每镜起手帧 + 收尾帧各拼一张大图,一屏二十几个镜头,a/b 对照就是运镜), 不是一张张翻。检测漏刀多刀用 recut 补刀并刀,自动重编号重算时长,手改边界过不了门。 产出 shots.json + Markdown 镜头表 + **单页交互式拉片报告**:内嵌播放器(播放时同步高亮镜头、 点镜头跳转)、镜头节奏带、可搜索可筛选可排序的镜头表(列表 / 卡片两种视图、首尾关键帧并排、 点图开大图)、景别类别运镜分布、出场人物、质量门、导出 JSON。单文件零依赖,离线双击能开。 15 道质量门全部由脚本确定性检查。 零依赖、零 API key,只要 node 和 ffmpeg。 Use when asked to 拉片、拆镜头、分析视频镜头、镜头时长、景别、运镜、镜头表、 video shot breakdown、shot list from video。
video-shots
给成片拉片, , 把一条片子拆成逐镜头的分析表:时长、景别、类别、运镜、画面。
前提刻在骨子里:镜头边界是量出来的,不是看出来的。 模型看视频最不可靠的就是报时间, , 「这个镜头大概 3 秒」和「2.97 秒」差的不是精度,是这份表能不能用。所以这里划一条死线:
| 谁来定 | 什么 | 怎么定 |
|---|---|---|
| 代码 | 切点、时长、片长、帧率 | ffmpeg 场景检测 + ffprobe,两位小数 |
| 代码 | 每个镜头的实测运动量 | 逐帧差分曲线的区间中位数(两端剔除,避开切点尖峰) |
| 模型 | 景别、类别、运镜、画面、节奏 | 看关键帧判断, , 只有这几件事是模型的活 |
| 代码 | 判断对不对 | 15 道质量门,逐条对账 |
最硬的一道门是运镜实测对账:摄影机真动了,像素不可能不变。所以「声称推/拉/摇/移/跟, 实测帧间变化接近 0」这一向直接拦, , 这是模型拉片最常见的幻觉。反过来(声称固定、实测很动) 不拦,只出提示:固定机位前面有人跳舞,帧间差一样会爆。
{baseDir} = 本文件所在目录。脚本 {baseDir}/scripts/video-shots.mjs,零依赖,node 直接跑。
边界(不做的事):不转写语音(没有 ASR,台词靠画面上烧录的字幕读,读不到就留空并说明)、
不做人脸识别与人物自动归并(cast 是人工编号)、不评价片子好坏(报告只给事实和统计)、
不剪辑不导出片段、不做镜头内的物体检测。
Step 0, 定输入与范围
只要一个视频文件。先问清两件事,问不到就按默认走并在汇报里说明:
- 拉全片还是拉一段:全片是默认。只要某一段就先用 ffmpeg 裁出来再拉,别在整片上标一半。
- 拉来干什么:做仿写参考(重画面与运镜)、做剪辑节奏分析(重时长与类别)、
做投放素材盘点(重产品镜与字卡)。用途不同,
note里该多记什么不同, , 表的结构是一样的。
Step 1, seed 工作底稿 ⛔ 切点在这一步定死
cd <输出目录>
node {baseDir}/scripts/video-shots.mjs seed <video> --track track.json --title "<片名>" > shots.json
stderr 会报:片长、帧率、分辨率、检测到几个切点、合并后几个镜头。先看这一行再往下走:
- 平均镜长十几秒、镜头数明显偏少 → 阈值高了,
--threshold 0.15重跑(暗戏、慢片、 同机位对话多的片子都要往下调) - 镜头数比肉眼数的多出一截 → 阈值低了,往
0.4调,或留到 Step 4 用recut --merge并 - 一条 3 分钟的片子跑完只要几秒钟,多跑两遍比将就一份烂底稿划算
底稿里 start / end / seconds / motion 已经填好,size / category / camera / frame 是空的, , 那四个空格子才是模型的活。
Step 2, 抽关键帧与联系表
node {baseDir}/scripts/video-shots.mjs frames shots.json --video <video>
node {baseDir}/scripts/video-shots.mjs sheet shots.json --cols 4 --rows 6
node {baseDir}/scripts/video-shots.mjs sheet shots.json --cols 4 --rows 6 --pick b
每镜两张:frames/S01a.jpg(起手 15% 处)和 S01b.jpg(收尾 85% 处)。
联系表把它们各拼成一张大图(行优先,S01 在左上),a 表看内容,b 表看运镜, , 同一格前后对照,取景变没变一眼就知道。
先看联系表,再看单帧。 一张张翻完整部片是浪费额度:一张联系表 = 二十几个镜头,
只在判不准的那几个镜头上回去看单帧(Read frames/S07a.jpg)。
Step 3, 逐批填四个字段
一批 ≤ 25 个镜头(正好一张联系表)。每批拿到:





